「攻撃」との違い
ここで紹介するアクセスは、攻撃ランキングで扱った悪意あるスキャンとは性質が異なります。User-Agentで身元を明かし、robots.txtに従い、存在しないファイルを執拗に探すような挙動もありません。検索エンジンのインデックス登録や、AIサービスの情報収集・技術調査が目的です。
第1章:検索エンジン・AIクローラー
本サイトを継続的に巡回している、身元の明らかなクローラーです。AI検索エンジン各社からも定期的にアクセスがあります。
| クローラー名 | 運営元 | 目的 | 観測した挙動 |
|---|---|---|---|
| Googlebot | Google検索のインデックス登録 | ほぼ毎日巡回。2026-11には従来と異なる新しいIP範囲(192.178.7.x)からの巡回を観測し、逆引きで本物と確認。詳細は1-5 | |
| GoogleOther | Google内部検索・品質評価用 | 定期的にアクセス。コンテナ内部構造・firewalld・SELinuxなど、掘り下げた技術ページを選んで取得する傾向 | |
| Googlebot-Image | 画像検索用インデックス | 画像ファイルを取得 | |
| bingbot | Microsoft | Bing検索のインデックス登録 | 複数IPから約12分間で50ページ以上を網羅的に取得する、大規模な初回クロールを確認 |
| Applebot | Apple | Siri・Spotlight向け検索 | robots.txt・トップページを定期取得 |
| OAI-SearchBot | OpenAI | ChatGPT検索機能向けインデックス | robots.txtを正しく取得。今後深い階層を読む可能性が高い |
| ChatGPT-User | OpenAI | ChatGPT経由でユーザーが実際に閲覧 | 実際のユーザー閲覧アクセスを確認 |
| ClaudeBot | Anthropic | AI学習・情報収集 | 技術文書ページを取得 |
| GPTBot | OpenAI | AIモデル学習用データ収集 | 技術文書ページを取得。2026-11-15にはsitemap.xmlを取得した直後に、新しく公開したシリーズの7ページと図解約30枚を、約35秒で一括して取得した |
| PerplexityBot | Perplexity AI | AI検索エンジン向けインデックス | robots.txtとトップページを取得 |
| DuckDuckBot | DuckDuckGo | DuckDuckGo検索のインデックス登録 | 定期巡回を確認 |
| DuckAssistBot | DuckDuckGo | AIアシスト機能(DuckAssist)向けの回答生成用データ収集 | robots.txt確認後に個別ページを取得する、行儀の良い巡回を確認 |
| archive.org_bot | Internet Archive | Wayback Machineへのウェブアーカイブ保存 | 個別ページを取得し保存する、行儀の良い巡回を確認 |
| Bravebot | Brave Search | Brave検索のインデックス登録 | robots.txt確認後にトップページを取得する、行儀の良い巡回順序を確認 |
| Amazonbot | Amazon | Alexa等のサービス向け検索インデックス | robots.txtを確認する、行儀の良い巡回。同じページを、短時間のうちに別のIPから複数回取得することもある |
| newsai/1.0 | AIニュース要約サービス(推定) | 技術記事をニュースソースとして利用する可能性 | まだ浅い階層(トップページ)のみだが、継続クロールに移行しつつある |
| Google-NotebookLM | AIノートツールでのWebページ取り込み・要約 | ゼロトラスト関連の最新ページ(ロードマップ・Phase0/1/2等)を集中的に取得。読者が調べ物に活用していると推測 | |
| meta-externalagent / facebookexternalhit | Meta | Facebook等でのリンクプレビュー生成・クロール | rockylinux配下のページ群を、補助ファイル(sheet001.htm等)まで含め広範囲に取得 |
| meta-webindexer | Meta | Meta AIの検索結果の品質向上(Metaの公式ドキュメントによる) | 2026-11-01にトップページを1回取得。送信元IPはMeta社の割り当て範囲にあり、User-Agentの記載とも一致。詳細は1-4 |
| Twitterbot | X(旧Twitter) | X投稿時のリンクプレビュー生成 | 複数IPからトップページ・robots.txtを取得。誰かがサイトのURLをXに投稿した際に発生 |
| Reflectionbot | Reflection AI | AI関連の情報収集・調査 | robots.txt確認後にトップページを取得する、行儀の良い巡回順序を確認 |
| ExaSearchBot | Exa | AI向け検索エンジンのインデックス登録 | robots.txtを確認してから、技術文書のページを個別に取得する、行儀の良い巡回を確認(2026-11-15)。送信元はホスティング事業者の範囲で、名乗りの裏付けはIPアドレスからは取れない |
1-1. 大規模なAI学習クロールの実例
一度に200件以上のページを連続で取得していく、大規模なAI学習目的と見られるクロールも確認しています。構築手順のページだけでなく、付随する画像・CSS・補助ページまで丁寧に取得しており、技術文書全体を構造ごと解析しているような挙動でした。サイトへの負荷という点でも問題になるレベルではありません。
1-2. 識別の参考になるUser-Agent
ログから実際に確認したUser-Agentの抜粋です。ご自身のサーバーでクローラーを識別する際の参考にしてください。
| クローラー | User-Agent(抜粋) |
|---|---|
| bingbot | compatible; bingbot/2.0; +http://www.bing.com/bingbot.htm |
| OAI-SearchBot | compatible; OAI-SearchBot/1.0; +https://openai.com/searchbot |
| newsai/1.0 | Chrome/140.0.0.0 newsai/1.0 Safari/537.36 |
| meta-externalagent | compatible; meta-externalagent/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler) |
| meta-webindexer | compatible; meta-webindexer/1.1 (+https://developers.facebook.com/docs/sharing/webmasters/crawler) |
| facebookexternalhit(正規) | facebookexternalhit/1.1 (+http://www.facebook.com/externalhit_uatext.php) |
| Twitterbot | Twitterbot/1.0 |
| Bravebot | compatible; Bravebot/1.0; +https://search.brave.com/help/brave-search-crawler |
| Amazonbot | compatible; Amazonbot/0.1; +https://developer.amazon.com/support/amazonbot |
| DuckAssistBot | DuckAssistBot/1.2; (+http://duckduckgo.com/duckassistbot.html) |
| archive.org_bot | compatible; archive.org_bot +http://archive.org/details/archive.org_bot) Zeno/7d76126 warc/v0.8.102 |
1-3. Chrome Privacy Preserving Prefetch Proxyと検索結果表示の関係
クローラーそのものではありませんが、Googlebotと並んでよく観測するアクセス元にChrome Privacy Preserving Prefetch Proxyがあります。192.178.14.x系のIPレンジから、/.well-known/traffic-adviceへの確認アクセスに続けて対象ページを取得していく挙動です。
これはChromeブラウザが、Google検索結果ページに表示されたリンクをユーザーがクリックする前に、プライバシー保護用のプロキシ経由で先読み(プリフェッチ)する仕組みです。この先読みは基本的に検索結果ページ上にリンクが表示された際に発生するため、このアクセスを観測できていること自体が「本サイトのページが検索結果に表示されている」ことを示す一つの手がかりになります。
ただし、これはあくまで検索結果への表示を示す手がかりであり、実際に閲覧者がそのリンクをクリックしたかどうかまでは分かりません。プリフェッチは表示された時点で先読みが走る仕組みのため、クリックの有無を判断する材料にはならない点に注意が必要です。
1-4. meta-webindexer:Metaのクローラーの使い分けと、本物かどうかの確かめ方
Metaは用途の異なる複数のクローラーを運用しており、このページの表にあるfacebookexternalhit・meta-externalagentとは別に、meta-webindexerというUser-Agentが存在します。Metaの公式ドキュメントでは、このクローラーの目的は「Meta AIの検索結果の品質向上のためにウェブを巡回すること」とされています。User-Agent名ごとに用途が分かれているため、robots.txtで制御する場合も、User-Agent名ごとに指定する形になります。
本サイトでは2026-11-01の早朝に、1つのIPアドレスからトップページを1回取得した記録がありました。応答は200で、追加の取得や存在しないファイルの探索はなく、挙動は穏当です。User-Agentには、ブラウザのような文字列に続けてmeta-webindexer/1.1と公式ドキュメントのURLが含まれていました。
本物かどうかの確かめ方
User-Agent文字列は誰でも書き換えられるため、名乗りだけでは本物と断定できません。Metaはクローラーごとの専用IP一覧は公開せず、Metaの自律システム(AS32934)が公開しているアドレス範囲を参照するよう案内しています。本サイトで確認した送信元IPは、公開WHOIS上でMeta Platforms Ireland Limitedの割り当て範囲(57.141.0.0〜57.149.255.255)に含まれており、User-Agentの記載と一致したため、本物と判断しました。なお、この送信元には逆引きDNSが設定されていませんでしたが、逆引きがないことだけでは偽物とは言えません(Metaの案内は、IPアドレス範囲での確認です)。アドレス範囲は変更されることがあるため、確認のたびにWHOISで見るのが確実です。
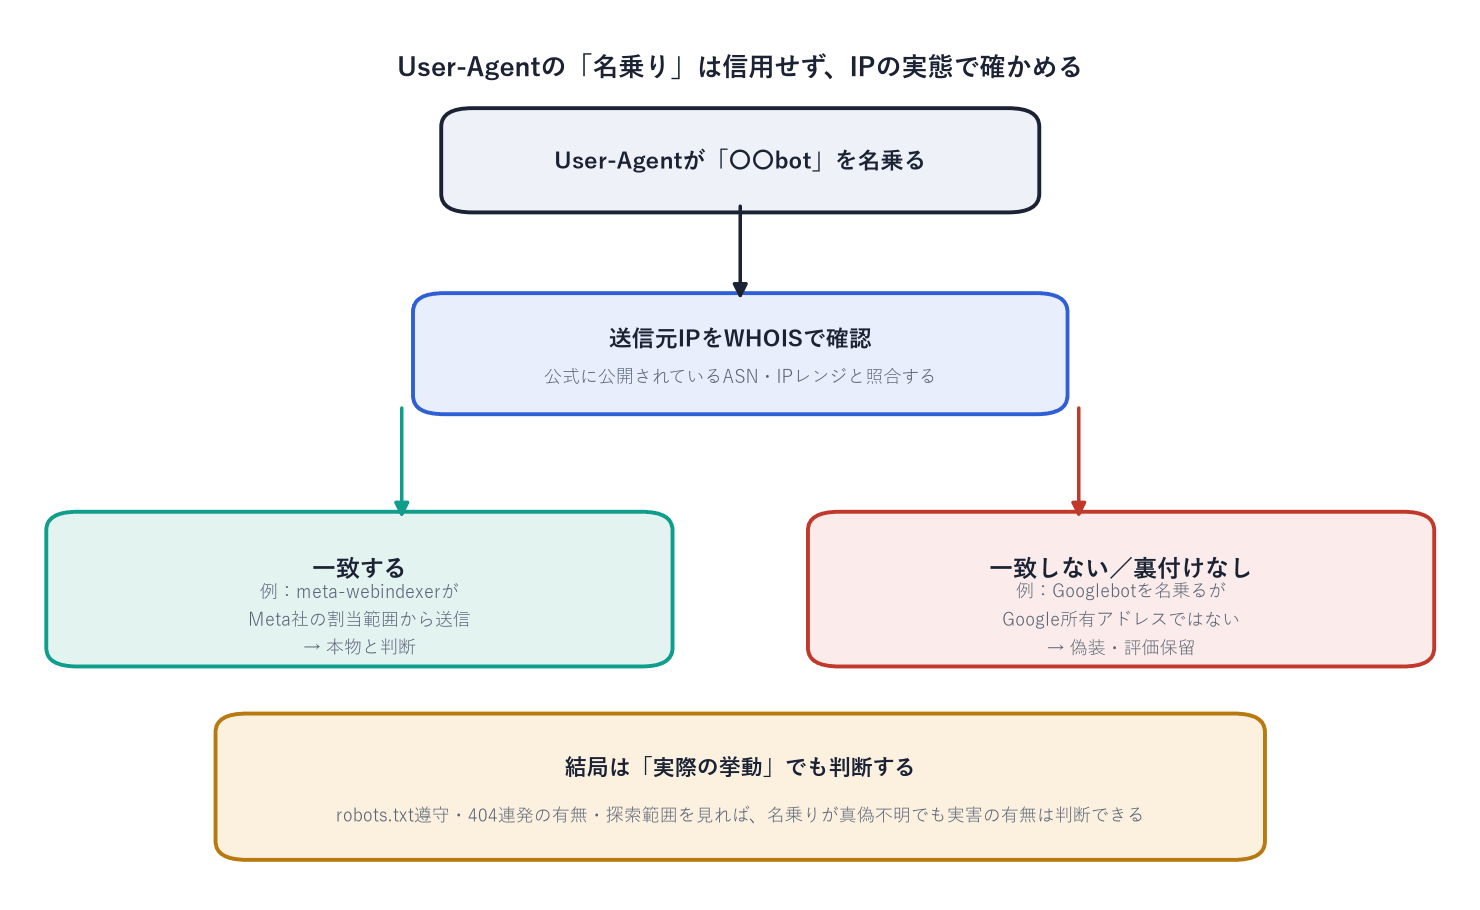
名乗りは誰でも書き換えられるため、WHOISでの実態確認と、robots.txt遵守等の実際の挙動の両方で判断する。
1-5. 逆引きとIP範囲で「本物のクローラー」を確かめる(2026-11の実例)
User-Agentは誰でも書き換えられます。そこで、送信元IPアドレスを逆引きして得たホスト名を、もう一度正引きして元のIPアドレスに戻るか(正引き一致)を確認すると、名乗りが本物かどうかを判断できます。本サイトで2026-11に実際に確認した例です。
| クローラー | 逆引きで得られるホスト名の形 | 確認結果 |
|---|---|---|
| Googlebot | crawl-192-178-7-194.googlebot.com | 正引き一致。Google所有のアドレスと確認 |
| bingbot | msnbot-52-167-144-66.search.msn.com | 正引き一致。Microsoft所有のアドレスと確認 |
| Applebot | 17-166-233-42.applebot.apple.com | 正引き一致。Apple所有のアドレスと確認 |
| Amazonbot | 54-88-84-219.crawl.amazonbot.amazon | 正引き一致。Amazon所有のアドレスと確認 |
| GPTBot / OAI-SearchBot | 逆引きの設定なし | 送信元はMicrosoft Azure上のアドレス。逆引きでは確かめられないため、IP範囲(運営元の公開情報)と実際の挙動で判断する |
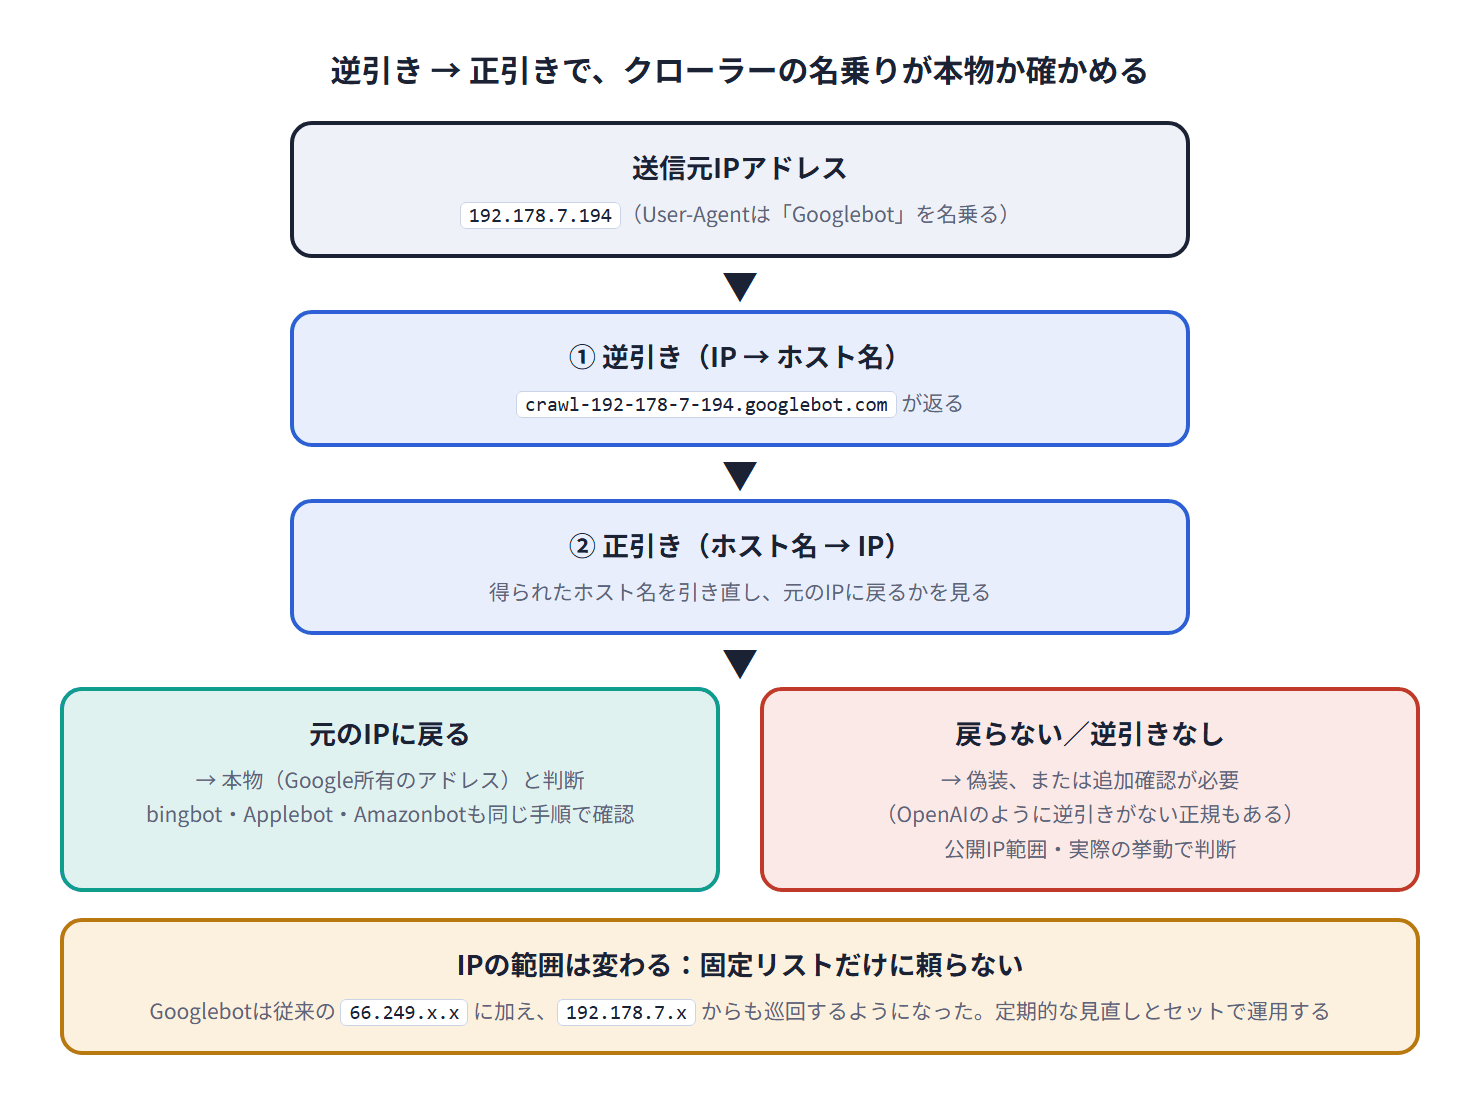
IPを逆引きし、得られたホスト名を正引きして元のIPに戻れば本物。範囲は変わるため固定リストだけに頼らない。
この確認で分かった実例が、Googlebotの送信元の変化です。以前は別のIP範囲(66.249.x.x)が中心でしたが、2026-11には192.178.7.xからの巡回が増えました。固定のIPアドレス一覧だけに頼ると、こうした範囲の変更で本物のクローラーを見落としたり、逆に誤って遮断したりしかねません。IPアドレスの一覧は変わるものとして、逆引き・正引きの確認と、定期的な見直しをセットで行うのが確実です。
なお、逆引きが設定されていないことだけでは偽物とは言えません(1-4のMetaや、上表のOpenAIがその例です)。逆引きがない場合は、運営元が公開しているIP範囲の一覧やWHOISと、robots.txtを守るかどうかといった実際の挙動を合わせて判断します。
第2章:無害な調査系スキャナー
攻撃目的ではなく、インターネット上のサービス実態を調査する目的のスキャナーです。セキュリティ研究機関や企業が、インターネット全体の状況把握のために運用しています。
| 種類 | 運営元の例 | 目的 | 観測した挙動 |
|---|---|---|---|
| 技術スタック調査 | BuiltWith | サイトが使用している技術の分析(SEO・市場調査向け) | 以前はfail2banに誤ってBANされていたが、現在は正常にクロールできている |
| サイト分析(技術構成・SEO・速度・構造) | visionheight.com/scan | BuiltWithと同カテゴリのサイト分析 | 深い階層まで構造解析。技術サイトとして登録され始めている可能性 |
| インターネット全体スキャン | Palo Alto Networks (Cortex Xpanse) | 自組織の顧客向け攻撃対象領域(Attack Surface)調査。UserAgentに調査目的を明記 | 無害 |
| インターネット全体スキャン | Censys(CensysInspect) | TLS/HTTP/セキュリティ構成の実態調査(セキュリティ研究) | トップページ・favicon.icoに200で正常応答。継続的に観測 |
| インターネット計測 | internet-measurement.com | 学術・研究目的のインターネット計測プロジェクト | 無害 |
| HTTP on SMTP | Shadowserver等 | メールサーバーの誤設定調査 | 無害 |
| SMTPバナー調査 | クラウド事業者 | EHLO応答の確認のみ | 無害 |
| 軽度ポートスキャン | クラウド事業者 | 公開ポートの存在確認のみ | 無害 |
| メディアモニタリング | trendiction(ドイツ) | メディア分析・検索向けの巡回。UAに連絡先を明記した正規ボット | 無害 |
| 特定CVEの検知プローブ | セキュリティ研究者・組織(推定) | 特定製品の既知脆弱性を持つホストが存在しないかの検知調査。UAに「無害な検知プローブのみ」と明記 | 本サイトとは無関係の製品向けプローブのため404で終了、無害 |
| 画像収集 | MochiImageCrawler(運営元未確認) | 不明。複数のクラウド事業者IPから、特定ページの画像ファイルを網羅的に取得 | 機密パスの探索や認証突破の試みはなし。UAを偽装せず自己申告している点は他の調査系スキャナーと共通だが、運営元・用途とも裏付けが取れておらず現時点では評価保留 |
| インターネット全体スキャン | Modat(ModatScanner) | インターネット全体をホスト単位で索引化する調査企業。運営元自身は用途を明確に文書化していない | トップページを取得、無害 |
| 不明 | RootEvidence(運営元未確認) | 不明。トップページのみ取得 | UAを偽装せず自己申告しているが、運営元・用途とも裏付けが取れておらず現時点では評価保留 |
| CMS構成の受動的調査 | ctdomain-cmsscan(運営元未確認) | UAに「受動的なCMS指紋調査、1サイトあたり最大5リクエストまで」と明記 | 低負荷・透明性の高い自己申告型、無害 |
| 汎用クローラー(用途は不明瞭) | HaloBot(公開情報ではHaloscanが運営。運営元自身の説明は確認できていない) | 検索・SEO分析・監視・データ収集などの汎用的な巡回とされるが、用途は公開情報でも明確ではない。詳細は2-3 | 2026-11-02にrobots.txtを取得してから、技術文書のページを1件取得。挙動は穏当だが、運営元・用途とも裏付けが取れておらず現時点では評価保留 |
| 法人情報の調査 | houjin-master-bot(運営元未確認) | 企業(法人)情報の調査・収集。UAに「company information research」と明記 | 2026-11-15にrobots.txtを取得してから、トップページと技術文書を数ページ取得。送信元は日本の一般向けインターネット回線で、データセンターではなく個人または小規模な運用とみられる。挙動は穏当で、無害寄り(評価保留) |
| ドメイン調査(研究) | domain-census(運営元未確認) | 研究目的のドメイン調査。UAに「1ドメインにつき1リクエスト」と明記 | 2026-11-14にトップページを1回だけ取得。UAの宣言どおりの挙動で、無害 |
| 汎用クローラー(用途は不明瞭) | Gort(運営元未確認) | 不明。UAがSafari 8系を名乗る | ほぼ毎日robots.txtだけを取得し、ページ本体は取得しない。送信元はAmazonのクラウド(EC2)上。評価保留 |
| 試験用とみられるクローラー | TestUserAgent/0.1(運営元未確認) | 不明。Amazonbotと同じブラウザ表記を使っており、試験用の可能性 | 2026-11-12にrobots.txtだけを1回取得。評価保留 |
2-1. 識別の参考になるUser-Agent
| 種類 | User-Agent(抜粋) |
|---|---|
| visionheight.com/scan | visionheight.com/scan Mozilla/5.0 ... |
| BuiltWith | 固定UAなし(Chrome系ブラウザのUAを使用) |
| Censys(CensysInspect) | Mozilla/5.0 (compatible; CensysInspect/1.1; +https://about.censys.io/) |
| trendictionbot | trendictionbot0.5.0; trendiction search; http://www.trendiction.de/bot |
| 特定CVEの検知プローブ | metabase-cve-2026-72898-detect/1.0 (benign detection probes only) |
| MochiImageCrawler | MochiImageCrawler/0.1 |
| ModatScanner | Mozilla/5.0 (compatible; ModatScanner/1.2); +https://modat.io/) |
| RootEvidence | RootEvidence/1.0 |
| ctdomain-cmsscan | ctdomain-cmsscan/0.1 (+passive CMS fingerprinting; max 5 requests/site) |
| HaloBot | Mozilla/5.0 (compatible; HaloBot/1.0) |
| houjin-master-bot | houjin-master-bot/1.0 (+company information research) |
| domain-census | domain-census/1.0 (research; one-request-per-domain) |
| Gort | Mozilla/5.0 (Macintosh; Intel Mac OS X 10_10_1) ... Version/8.0.2 Safari/600.2.5 (Gort) |
2-2. 身元を明かさない分散型クローラーの実例(2026-08-15)
2026年8月15日未明の3分間、5つの異なるホスティング事業者のIPアドレスから、同一のブラウザ用User-Agent(Firefox)を使って、robots.txt・sitemap.xmlに加え.well-known/配下の各種メタデータファイル(セキュリティポリシー、OpenID設定、アプリ連携情報など)やRSS/Atomフィードの存在を網羅的に確認していく挙動を観測しました。並行して実際の技術文書ページも複数閲覧しており、単純な脆弱性探索とは異なります。特定の事業者名を名乗るUser-Agentではなく、複数の送信元IPにまたがって短時間に組織的に行われている点が、本章の他の調査系スキャナーとは異なる特徴です。認証情報や管理画面を狙うような攻撃的な探索は確認されておらず、実害はありません。なお、存在しないファイルへのアクセス数が多かったことから、送信元IPの一部はapache-404の監視ルールにより数時間後に自動的にBANされたことを確認しています。
これらは攻撃ランキングで扱った攻撃とは異なり、脆弱なファイルを探したり、ログイン試行を繰り返したりする挙動はありません。「調べているだけ」で終わっています。
2-3. HaloBot:運営元がIPアドレスからは確かめられない例(2026-11-02)
2026-11-02の朝、1つのIPアドレスから、robots.txtを取得した後に技術文書のページを1件取得していきました。User-AgentはMozilla/5.0 (compatible; HaloBot/1.0)とだけ名乗る自己申告型で、連絡先のURLは含まれていません。robots.txtを先に確認する順序は行儀のよい巡回の特徴で、存在しないファイルの探索や認証を破ろうとする試みもありませんでした。
運営元については、Known AgentsやDark Visitorsといった公開のクローラー辞典に、Haloscanというサービス事業者が運営するエージェントとして掲載されています。ただし用途は分類されておらず、robots.txtを守るかどうかも、User-Agent文字列だけでは証明できません。運営元側が公開している確認方法(IP一覧や逆引きの規則)も見つかりませんでした。
送信元のIPは、公開WHOIS上でフランスのホスティング事業者(OVH SAS)の割り当て範囲でした。これは運営元の自称と矛盾するものではありませんが、ホスティング事業者の汎用の範囲であるため、運営元の裏付けにはなりません。また、名前の似たHaloAgentsAI-Crawler/1.0という別のクローラーも存在し、こちらは別の運営元が仕様を公開しているため、混同しないよう注意が必要です。
本サイトでは、運営元が確かめられないクローラーについては、名乗りではなく実際の挙動で判断しています。HaloBotは現時点で、負荷・探索行為のいずれも問題がなく、評価保留(無害寄り)としています。
2-4. ブラウザを名乗る機械の見分け方(2026-11)
クローラーの中には、User-Agentにクローラー名を書かず、普通のブラウザ(ChromeやSafari)を名乗って巡回するものがあります。アクセス数やアクセス元の分析では、これらを「人の閲覧」と混同しないことが大切です。本サイトのログでは、次の観点で人と機械を見分けています。
| 観点 | 人の閲覧 | ブラウザを名乗る機械 |
|---|---|---|
| 画像・アイコン(favicon) | ページと一緒に画像やfaviconも読み込む | HTMLだけを取得し、画像もfaviconも取得しないことが多い |
| 参照元 | 検索結果(Google・Bing・Yahoo!など)から、または他のページから | 参照元がない、または常に本サイトのトップページ |
| 動き | 複数のページを順に読み、回遊する | 1ページだけを取得して終わる |
| 回線 | 日本の一般家庭・会社の回線が中心 | ホスティング事業者、または海外の一般家庭向け回線(住宅用プロキシとみられる) |
| 同時性 | — | 同じブラウザ表記で、数分のうちに複数の別IPが別のページを取得する |
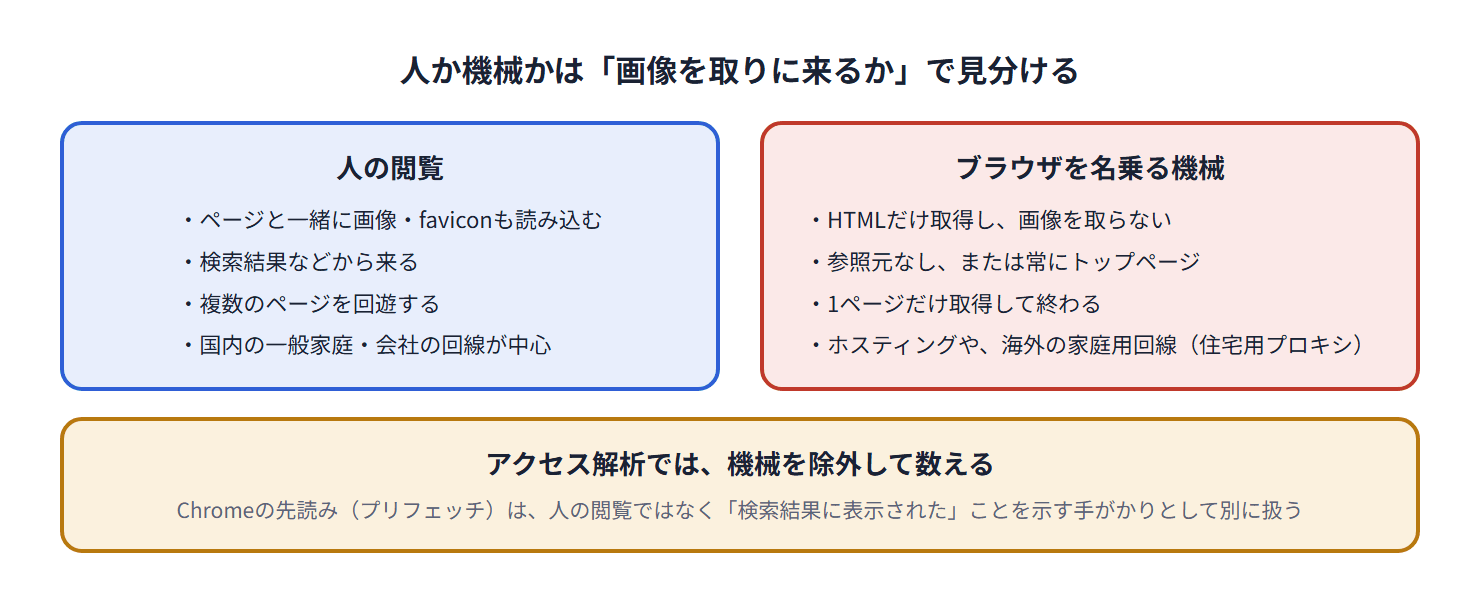
画像を取りに来るかどうかが、人と機械を見分ける最も分かりやすい手がかり。
2026-11に観測した、代表的な3つの型です。
- 同じ環境を名乗る多数のIP:「Mac上のChrome」という同一の表記で、日ごとに増えるIPが、数分の間に3つ前後ずつ、セキュリティ関連のページを1ページずつ取得していく。画像は取得しない。
- 参照元がトップページだけの、海外の一般家庭向け回線:フランス・英国・米国などの一般向け回線から、「トップページから来た」ことにして1ページだけを取得する。人の閲覧と見分けにくいが、画像を取得しない点で見分けられる。住宅用プロキシ(一般家庭の回線を貸し出す仕組み)を経由した自動巡回とみられる。
- 毎日ほぼ同じ時刻に、IPだけが変わる巡回:毎日15時台に、日本のクラウド(VPS)から、拡張子を省いた同じURLを取得して404になる。送信元のIPは同じ事業者の範囲の中で毎日入れ替わっており、定期実行されるプログラムの動きとみられる。
これらは、いずれも負荷が小さく、機密パスの探索や認証を破ろうとする挙動もないため、実害は確認されていません。ただし、アクセス解析で「人の閲覧者数」を数える際は、除外する必要があります。なお、1-3で触れたChromeの先読み(プリフェッチ)も、人の閲覧ではなく、検索結果への表示を示す手がかりとして別に扱います。
第3章:正規クローラーを誤ってBANしないための設定
Fail2banの「存在しないページへの連続アクセス」を検知する監視ルールは、本来は脆弱性を探すスキャン行為を検知するためのものです。しかし正規のクローラーであっても、サイト構成の変更やリンク切れによって偶発的に404を連発することがあり、そのままでは正規クローラーごと誤ってBANしてしまうことがありました(第2章のBuiltWithが実際にこれで一度BANされた事例です)。
クローラーに限らず、一般の閲覧者側でも同様の問題が起き得ます。ブラウザやOSが裏側で自動的に確認する「よくあるお約束のファイル」(アイコン画像など)をサイト側に用意していないと、その自動確認そのものが404を連発し、閲覧者本人を誤ってBANしてしまうことがあります。この実例は「対策・対応の記録」第4章で紹介しています。
そこでこの監視ルールに限定して、実際にログで継続的な巡回が確認できた、クラウド事業者側が公開・運用している送信元IPレンジを対象外に登録しています。他の監視(明確に悪意ある挙動を検知するルール)にはこの除外を適用していません。あくまで「404を連発しても即座に締め出さない」対象を絞り込んでいるだけで、他の不審な挙動があれば通常どおり遮断されます。User-Agent文字列は誰でも自由に詐称できるため信頼せず、IPアドレスの実態のみで判断する方針にしています。実際に「Googlebot」を名乗りながら実際のGoogle所有アドレスとは異なる送信元から既知の脆弱性パスを探索するアクセスも観測しており、この種の偽装は専用の検知ルールではなく、あくまで前述の「存在しないページへの連続アクセス」を検知する監視ルールが結果的に機能することで遮断される場合があるにとどまります。1回限りのアクセスなど連続404に達しない範囲の偽装は現状すり抜ける可能性がある点は今後の課題です。
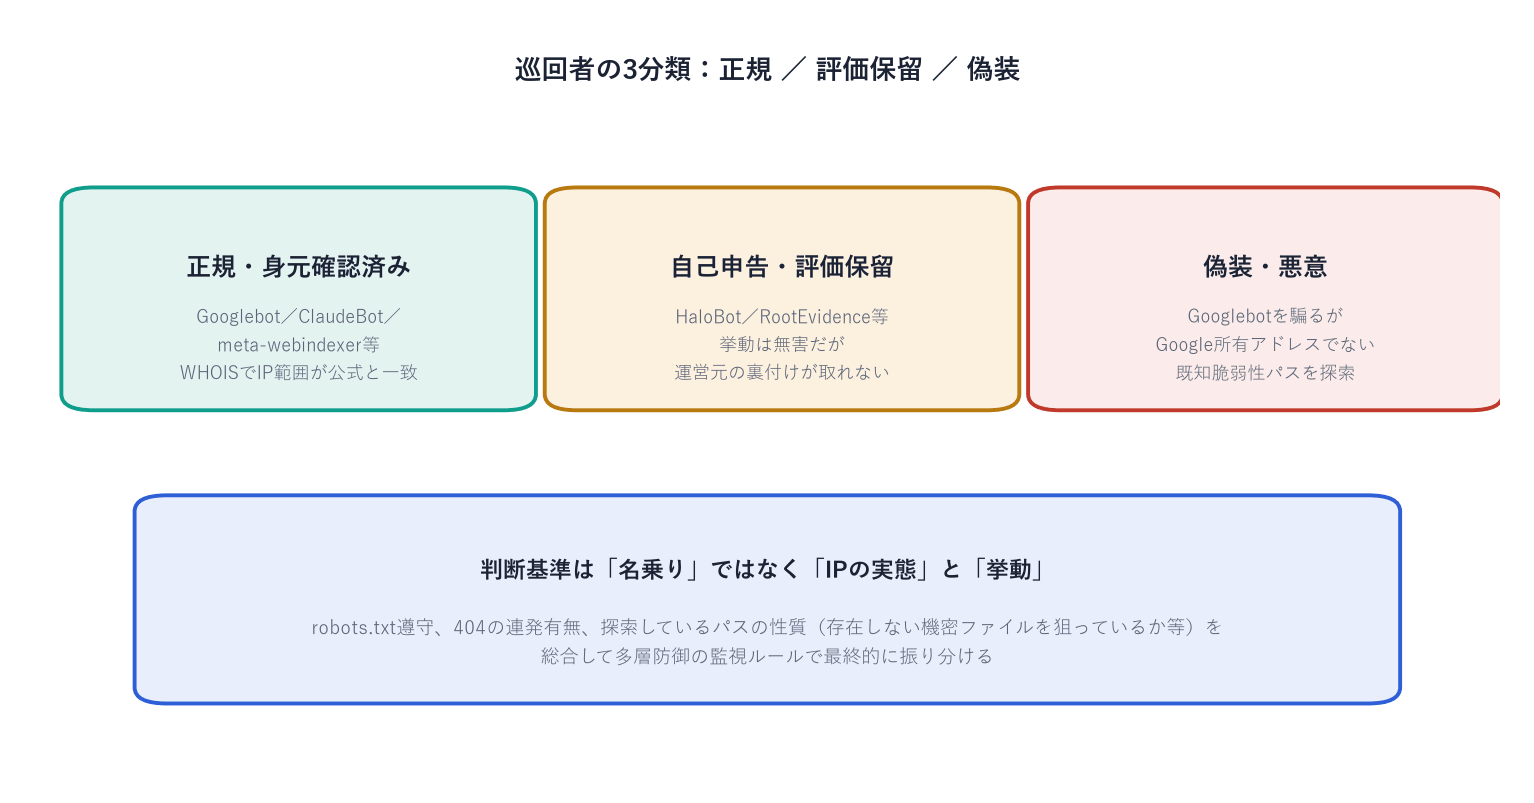
「正規」「評価保留」「偽装」の3分類。判断基準は名乗りではなく、IPの実態と実際の挙動。
第4章:総括
2026-11-15時点で、新しく公開したシリーズが、公開から数日のうちにGPTBot・Googlebot・bingbotの3つに取り込まれていることを確認しました。サイトマップの整備が、新しいページの発見に効いていると考えられます。一方で、ブラウザを名乗る機械のアクセスも増えており、クローラー名で名乗る正規のクローラーと、名乗らない機械を分けて見る必要性が高まっています(2-4)。
主要な検索エンジン(Google, DuckDuckGo)とAI検索エンジン(OpenAI, Perplexity, Anthropic)の双方から日常的に巡回されている状態です。robots.txt・sitemap.xmlを整備したことで、今後さらにクロールの効率が上がることを期待しています。
実際に受けた攻撃の分析は「攻撃ランキング」、多層防御の考え方は「対策・対応の記録」をご覧ください。
クローラー紹介、整理完了 🤖
主要な検索エンジン・AIサービスから巡回されていることを確認できました。